怎麼才剛過完年 元宵都還沒過
我就得頂著寒風細雨騎著車上學
我跟被窩的約會不應該就此打住
貪戀著假期的懶散茫然 仍舊無法適應嚴肅的課堂
還沒來得及跟小說道再見 莫名奇妙的拼音文字已經綁架了我的雙眼
放假借的那本小說 至今仍擱在床頭 動也不動 灰塵滿佈
我一邊消沉於無所事事的日子 另一方面卻又懼怕著漫天撲地而來的學習夢魘
老師總是要人自我介紹 除了名字學號還要說說研究興趣
講到研究興趣腦袋總是一片空白 我到現在還是不知道自己在幹嘛
最後我就說了「我的研究方向沒有什麼好說的」
我也不過就只上了四門課 是有什麼方向可以走
總是在哄堂大笑之後感到一絲絲的寂寥
第一次上課老師發下了「如果讓我重做一次研究生」
很久以前就看過了
那然後呢?
然後呢...
沒有然後了
只能雖不能至 然心嚮往之
如此而已
再讓我睡個好覺吧
可能一覺醒來
一個學期又結束了......

2008年2月17日 星期日
我的宜蘭行
1/27 陰有雨
昨夜收拾行李 收拾到一半發現 不就是去兩天 帶那麼多東西是要幹嘛 練身體喔
於是拋開了一切 鑽入被窩 好好的睡上一覺
清晨醒來 窗外的雨不停落下 讓我不禁懷疑 未來的兩天 我會不會走在大雨裡的宜蘭
想了也是白搭 包袱款了款就出門坐公車了
HIPPO在聯合報等了我半個小時 ㄎㄎ 反正首都之星班次一堆 你想要沒車都很難
下了公車 到7-11買了個飯團跟水 便到一旁候車站排起了隊
車不一會就來了 趕巧 我們是排頭 可是HIPPO挑了一個很詭異的位子
上車之後就開始睡覺 畢竟高速公路的風景總是那般一成不變
約莫過了1個多小時 宜蘭就到了 於是我們開始了宜蘭市區縱走深度之旅的行程
本行程完全參考"宜蘭深度旅遊" 依該書所言 縱橫整個宜蘭市區必須要8個小時 而我們走了5個小時
完全就是健行之旅
下得車來 眼前的景物有點熟悉 HIPPO說 前年去梨山探路也是在這裡換車
無怪乎 停滿機車的人行道對我總有種說不上來的親切感
雖然手上有本旅遊書 可總是有些不安 推開了車站旁的旅客中心 進去要了份地圖
兩相比較之下 有"宜蘭深度旅遊"一書足矣
攤開了書本 我們第一個目的地是....泰山石敢當....
........完全看不出任何肅穆之氣 因為它著色著的很醜 完全跳脫了古物所應有的色彩
接著繼續走 來到了阿茂米粉羹 雖然才剛把飯糰吃完 還是進去點了一碗
.........原來我大老遠跑來宜蘭是為了吃像大腸麵線的米粉羹 可是碗裡一個大腸跟蚵仔也沒有 教人好生惆悵
第二個景點就是第二個泰山石敢當 它藏在一個我差點擠不進去的巷子裡
這一尊感覺比較受人尊重 前面有插鮮花 香爐也有餘燼 HIPPO還是很堅持要跟它合影
然後我們直奔北門蒜味肉羹 這一家感覺挺賺錢的 偌大的門面 不到中午時分就擠了個水洩不通
媽的B我硬是在鍋爐旁邊等了10分鐘 蒸的我快熟了
坐下來點了兩碗粿仔 嚐起來倒也新鮮 滿滿的蒜味
坐在一旁的一家人中的先生說了 "這個粿仔沒有三重好吃"
可是今天是我第一次吃粿仔 我無從分辨 而且在我的印象中這個玩意應該叫米苔目...
原本想拿出我的相機拍拍照的 可是這是它還沉浸在冷氣裡 鏡頭還來不及起床

吃完了肉羹 接著喝北門綠豆沙解解渴
....該死的前面一家人點了15杯 點那麼多做什麼 你吸管是要插到鼻孔去喝喔
就看著老闆一下子開冰櫃 一下子倒牛奶 一下子開果汁機 一下子用封口機....
最後等了15分鐘才拿到一杯小小的芋頭沙
綿密的口感 正對味 值了!
走一走就到了城隍廟 一旁都是棺材店 然後我又有了疑問
根據觀察 那裡的棺材又分成兩種 一種是長方形的 棺材板感覺還有個小窗戶可以瞻仰遺容
另一種是傳統的木板寶蓋 前後會貼"福"字的那種 有人可以說說兩種有什麼差嗎
城隍廟跟書上寫的一樣 比一般的廟宇矮了很多 進得門來 兩旁放了大大小小造型不一的七爺八爺
我一直怕把相機拿出來會被廟祝打 結果一張也沒拍
看了看神像又走了出來
跟著書上的導覽景點 原本要去岳廟碧霞宮的 可是它門外貼著封印大典 裡面的人又肅穆莊嚴一動也不動
我很怕進去參觀會打擾了他們 所以只好悵然的跳過它
經過文昌廟的時候 HIPPO進去上廁所 然後拿了張文昌帝君護貝閃卡 我實在搞不懂她在想什麼
走走停停 來到的昭應宮

我迫不及待的跑上二樓想要看看三大老 木雕 我也不知道自己在興奮什麼
二樓還有奉祀大禹 拜大禹是求治水嗎?
出了廟門 看了看地圖 下一站是宜蘭酒廠
途經打鐵街 腦中想像的是鐵匠拿著燒紅的鐵 汗水淋漓的敲打
可映入眼簾的是一個個的阿伯坐在板凳上看著電視 OTZ
地圖上小小的距離 感覺好像走了半個小時
路上有一條狗一直尾隨著我們
然後狗只是不經意的從HIPPO身旁用牠的背脊觸碰了一下她的手 HIPPO便放聲尖叫
......我看見一旁的機車騎士放慢了油門經過我們

不是假日的宜蘭酒廠 也是不少人 果然是個觀光景點
可惜手上銀兩不多 拿個根冰棒還有一支香腸 這個景點就消失在我們的旅途之中
橫越過酒廠旁的馬路便是宜蘭設置紀念館 門口的牌子寫著進門得花20塊
結果又是另一個日式木造宿舍造型館

進去不免俗的就是脫鞋 禁止拍照 走在榻榻米上的感覺 不管到哪裡都是一樣的
總不會說 你現在走的這塊榻榻米有80年的歷史 我想八十年的塌塌米應該爛掉了吧...
裡面有放一個仿的三大老木雕 漆上的很亮 其他的就是宜蘭市介紹了
園內的日式庭園 感覺失修多年 一旁的水池也是乾巴巴的 還有張椅子缺了一腳
走出來的對面有一堵牆 不知道是什麼 可它掛了歷史建築的牌子

清潔的阿姨說旁邊還有一個音樂館也可以參觀 裡面放滿了樂器 還有台百來年的鋼琴


然後我們結束了這個區塊的行程
下一站是很少被提到的宜蘭監獄 我們沿著準備蓋家樂福的工地走著
走著走著 一路的泥濘
眼前的大門深鎖 裡頭一點光亮也沒有 我抬頭看向一旁的開放時間 想著是不是來錯了時間
接著探頭往建築物裡看了看 ....空蕩蕩的 ...空蕩蕩的 ....空蕩蕩的!!
很遺憾的結束了這個景點 下一站是黑店冰店
"沒開"
經過ㄧ家賣牛舌餅的 可是裝潢很破落 燈光很昏暗 感覺是騙外地人的 所以也沒買
走著走著也大概2點多了 決定結束宜蘭的行程 往羅東出發
往火車站的路上 宜蘭公園正在舉辦年貨大街 趕巧在發購物袋
HIPPO見狀 便不落人後的擠進人群拿了兩個戰利品出來
到羅東已是三點多 車站外細雨紛飛 不同於宜蘭的和煦冬陽 此地寒風冷冽 凍的我直打哆嗦
租車的老闆問我要不要買雨衣 我也不知道為什麼說不要 蓋了本票之後 騎上車就走了
結果雨越下越大 我在田野間馳騁 雨水打在我的臉上 又冷又餓
轉過了一個大彎才到了民宿"糖果屋"
架好了車 原本以為老闆會出來迎接我們 但屋內空蕩蕩的 寂靜異常
之後晃了一下子才找到人登記住房
進到房間 就睡了....
睡到5點多 起身更衣 倆人前往羅東夜市就晚膳
一路上還是很冷
第一站本想吃個遠近馳名的阿灶伯羊肉 可人潮多的實在駭人 於是作罷
一串心也賣完了 老闆感覺不想做 只吃了旁邊的龍鳳腿跟炸春捲
之後又吃了蔥抓餅-HIPPO要求、卜鴨冬粉
外帶滷味跟卜肉回民宿吃
烤肉的攤位沒有籃子 讓我不知如何下手 而且也沒有喜歡的料 所以就沒買了
包心粉圓的人也是多到不行 所以逕行跳過
回到民宿 看了一下連續劇 就睡了
1/28 晴朗無比
起床 窗簾隱藏不住外頭的天氣 太陽的光芒一個勁的往屋裡頭鑽 天氣真好
民宿的用餐區由一片片的落地窗所圍成 早餐為柳橙汁 三明治 鑫鑫腸 果凍 大蒜麵包
風景挺別緻的
把行李全部塞在機車裡之後 前往國立傳統藝術中心

才剛到 就有表演節目 "鯽仔魚娶親"
可真是純粹的哄小孩 HIPPO看的挺專注的 由此可見一般

不合我胃口
我比較期待那種霞披鳳冠 轎子 嗩吶之類的 我比較old fashion
看完了表演 看了一下文昌祠

繞到黃舉人宅看了看

接著把民藝大街前前後後的店走了一遭

裡頭的店員說這是半個月來第一個晴天 這麼巧 被我趕上了
可惜我對於自己動手做的活動很提不起勁 我比較偏向用眼睛看的活動
另一條路也是自己做大街 很快的穿越
展覽館裡頭 是一件件不能拍照的編織品 然後我們一個接著一個打起了呵欠 ㄎㄎ
感覺很快速的離開了傳藝中心
接著是小吃之旅
第一站是林廠肉羹 吃起來普普通通 可吃著吃著游錫堃就出現了 光頭油亮油亮的
但是店員一開始叫不出他名字 嘖嘖 接著店主人就出來寒喧了
吃完往前騎了一會 欲往林業文化區
可是裡頭看起來不是給人參觀的 轉了一圈掉頭去吃臭豆腐
不知道為什麼 點臭豆腐的同時又點了米粉羹 明明知道它就是大腸麵線還是點了
臭豆腐吃起來帶汁 挺鮮的
最後到了白天的羅東夜市 為了完成昨天沒吃到的遺憾
可是阿灶伯沒開 不過包心粉圓人很少 送
買了個奇怪的宜蘭餅就去還車了
旅程本該就此結束 啟程返家 可怎奈HIPPO魂牽夢縈著宜蘭市的瓜仔雞麵
所以當我回過神的時候 我又出現在宜蘭火車站外
走上前一天走過的路 我跟宜蘭越來越熟悉
點了瓜仔雞麵後 順便到隔壁買了三十年老店愛玉冰
一旁的EASY SHOP店員聲嘶力竭的叫賣促銷 可憐它的大聲公沒有錄音功能
吃著的當間 一陣嗩吶聲 一旁的大馬路出現了出殯的隊伍......
結束瓜仔雞麵 接著吃信利號貓耳朵
...說什麼貓耳朵類似水晶餃 它就是水晶餃!!! 騙人也不是這個樣子
吃著吃著 EASY SHOP的店員又出現了 沿街叫賣 路過店家也進去給歐巴桑一張DM
兩人摸著渾圓的肚皮 坐上首都之星 回台北
--
宜蘭叫人猜不透的是 為什麼年輕人的機車都要拆後照鏡 ..... 後方來車很危險耶
昨夜收拾行李 收拾到一半發現 不就是去兩天 帶那麼多東西是要幹嘛 練身體喔
於是拋開了一切 鑽入被窩 好好的睡上一覺
清晨醒來 窗外的雨不停落下 讓我不禁懷疑 未來的兩天 我會不會走在大雨裡的宜蘭
想了也是白搭 包袱款了款就出門坐公車了
HIPPO在聯合報等了我半個小時 ㄎㄎ 反正首都之星班次一堆 你想要沒車都很難
下了公車 到7-11買了個飯團跟水 便到一旁候車站排起了隊
車不一會就來了 趕巧 我們是排頭 可是HIPPO挑了一個很詭異的位子
上車之後就開始睡覺 畢竟高速公路的風景總是那般一成不變
約莫過了1個多小時 宜蘭就到了 於是我們開始了宜蘭市區縱走深度之旅的行程
本行程完全參考"宜蘭深度旅遊" 依該書所言 縱橫整個宜蘭市區必須要8個小時 而我們走了5個小時
完全就是健行之旅
下得車來 眼前的景物有點熟悉 HIPPO說 前年去梨山探路也是在這裡換車
無怪乎 停滿機車的人行道對我總有種說不上來的親切感
雖然手上有本旅遊書 可總是有些不安 推開了車站旁的旅客中心 進去要了份地圖
兩相比較之下 有"宜蘭深度旅遊"一書足矣
攤開了書本 我們第一個目的地是....泰山石敢當....
........完全看不出任何肅穆之氣 因為它著色著的很醜 完全跳脫了古物所應有的色彩
接著繼續走 來到了阿茂米粉羹 雖然才剛把飯糰吃完 還是進去點了一碗
.........原來我大老遠跑來宜蘭是為了吃像大腸麵線的米粉羹 可是碗裡一個大腸跟蚵仔也沒有 教人好生惆悵
第二個景點就是第二個泰山石敢當 它藏在一個我差點擠不進去的巷子裡
這一尊感覺比較受人尊重 前面有插鮮花 香爐也有餘燼 HIPPO還是很堅持要跟它合影
然後我們直奔北門蒜味肉羹 這一家感覺挺賺錢的 偌大的門面 不到中午時分就擠了個水洩不通
媽的B我硬是在鍋爐旁邊等了10分鐘 蒸的我快熟了
坐下來點了兩碗粿仔 嚐起來倒也新鮮 滿滿的蒜味
坐在一旁的一家人中的先生說了 "這個粿仔沒有三重好吃"
可是今天是我第一次吃粿仔 我無從分辨 而且在我的印象中這個玩意應該叫米苔目...
原本想拿出我的相機拍拍照的 可是這是它還沉浸在冷氣裡 鏡頭還來不及起床
吃完了肉羹 接著喝北門綠豆沙解解渴
....該死的前面一家人點了15杯 點那麼多做什麼 你吸管是要插到鼻孔去喝喔
就看著老闆一下子開冰櫃 一下子倒牛奶 一下子開果汁機 一下子用封口機....
最後等了15分鐘才拿到一杯小小的芋頭沙
綿密的口感 正對味 值了!
走一走就到了城隍廟 一旁都是棺材店 然後我又有了疑問
根據觀察 那裡的棺材又分成兩種 一種是長方形的 棺材板感覺還有個小窗戶可以瞻仰遺容
另一種是傳統的木板寶蓋 前後會貼"福"字的那種 有人可以說說兩種有什麼差嗎
城隍廟跟書上寫的一樣 比一般的廟宇矮了很多 進得門來 兩旁放了大大小小造型不一的七爺八爺
我一直怕把相機拿出來會被廟祝打 結果一張也沒拍
看了看神像又走了出來
跟著書上的導覽景點 原本要去岳廟碧霞宮的 可是它門外貼著封印大典 裡面的人又肅穆莊嚴一動也不動
我很怕進去參觀會打擾了他們 所以只好悵然的跳過它
經過文昌廟的時候 HIPPO進去上廁所 然後拿了張文昌帝君護貝閃卡 我實在搞不懂她在想什麼
走走停停 來到的昭應宮
我迫不及待的跑上二樓想要看看三大老 木雕 我也不知道自己在興奮什麼
二樓還有奉祀大禹 拜大禹是求治水嗎?
出了廟門 看了看地圖 下一站是宜蘭酒廠
途經打鐵街 腦中想像的是鐵匠拿著燒紅的鐵 汗水淋漓的敲打
可映入眼簾的是一個個的阿伯坐在板凳上看著電視 OTZ
地圖上小小的距離 感覺好像走了半個小時
路上有一條狗一直尾隨著我們
然後狗只是不經意的從HIPPO身旁用牠的背脊觸碰了一下她的手 HIPPO便放聲尖叫
......我看見一旁的機車騎士放慢了油門經過我們
不是假日的宜蘭酒廠 也是不少人 果然是個觀光景點
可惜手上銀兩不多 拿個根冰棒還有一支香腸 這個景點就消失在我們的旅途之中
橫越過酒廠旁的馬路便是宜蘭設置紀念館 門口的牌子寫著進門得花20塊
結果又是另一個日式木造宿舍造型館
進去不免俗的就是脫鞋 禁止拍照 走在榻榻米上的感覺 不管到哪裡都是一樣的
總不會說 你現在走的這塊榻榻米有80年的歷史 我想八十年的塌塌米應該爛掉了吧...
裡面有放一個仿的三大老木雕 漆上的很亮 其他的就是宜蘭市介紹了
園內的日式庭園 感覺失修多年 一旁的水池也是乾巴巴的 還有張椅子缺了一腳
走出來的對面有一堵牆 不知道是什麼 可它掛了歷史建築的牌子
清潔的阿姨說旁邊還有一個音樂館也可以參觀 裡面放滿了樂器 還有台百來年的鋼琴
然後我們結束了這個區塊的行程
下一站是很少被提到的宜蘭監獄 我們沿著準備蓋家樂福的工地走著
走著走著 一路的泥濘
眼前的大門深鎖 裡頭一點光亮也沒有 我抬頭看向一旁的開放時間 想著是不是來錯了時間
接著探頭往建築物裡看了看 ....空蕩蕩的 ...空蕩蕩的 ....空蕩蕩的!!
很遺憾的結束了這個景點 下一站是黑店冰店
"沒開"
經過ㄧ家賣牛舌餅的 可是裝潢很破落 燈光很昏暗 感覺是騙外地人的 所以也沒買
走著走著也大概2點多了 決定結束宜蘭的行程 往羅東出發
往火車站的路上 宜蘭公園正在舉辦年貨大街 趕巧在發購物袋
HIPPO見狀 便不落人後的擠進人群拿了兩個戰利品出來
到羅東已是三點多 車站外細雨紛飛 不同於宜蘭的和煦冬陽 此地寒風冷冽 凍的我直打哆嗦
租車的老闆問我要不要買雨衣 我也不知道為什麼說不要 蓋了本票之後 騎上車就走了
結果雨越下越大 我在田野間馳騁 雨水打在我的臉上 又冷又餓
轉過了一個大彎才到了民宿"糖果屋"
架好了車 原本以為老闆會出來迎接我們 但屋內空蕩蕩的 寂靜異常
之後晃了一下子才找到人登記住房
進到房間 就睡了....
睡到5點多 起身更衣 倆人前往羅東夜市就晚膳
一路上還是很冷
第一站本想吃個遠近馳名的阿灶伯羊肉 可人潮多的實在駭人 於是作罷
一串心也賣完了 老闆感覺不想做 只吃了旁邊的龍鳳腿跟炸春捲
之後又吃了蔥抓餅-HIPPO要求、卜鴨冬粉
外帶滷味跟卜肉回民宿吃
烤肉的攤位沒有籃子 讓我不知如何下手 而且也沒有喜歡的料 所以就沒買了
包心粉圓的人也是多到不行 所以逕行跳過
回到民宿 看了一下連續劇 就睡了
1/28 晴朗無比
起床 窗簾隱藏不住外頭的天氣 太陽的光芒一個勁的往屋裡頭鑽 天氣真好
民宿的用餐區由一片片的落地窗所圍成 早餐為柳橙汁 三明治 鑫鑫腸 果凍 大蒜麵包
風景挺別緻的
把行李全部塞在機車裡之後 前往國立傳統藝術中心
才剛到 就有表演節目 "鯽仔魚娶親"
可真是純粹的哄小孩 HIPPO看的挺專注的 由此可見一般
不合我胃口
我比較期待那種霞披鳳冠 轎子 嗩吶之類的 我比較old fashion
看完了表演 看了一下文昌祠
繞到黃舉人宅看了看
接著把民藝大街前前後後的店走了一遭
裡頭的店員說這是半個月來第一個晴天 這麼巧 被我趕上了
可惜我對於自己動手做的活動很提不起勁 我比較偏向用眼睛看的活動
另一條路也是自己做大街 很快的穿越
展覽館裡頭 是一件件不能拍照的編織品 然後我們一個接著一個打起了呵欠 ㄎㄎ
感覺很快速的離開了傳藝中心
接著是小吃之旅
第一站是林廠肉羹 吃起來普普通通 可吃著吃著游錫堃就出現了 光頭油亮油亮的
但是店員一開始叫不出他名字 嘖嘖 接著店主人就出來寒喧了
吃完往前騎了一會 欲往林業文化區
可是裡頭看起來不是給人參觀的 轉了一圈掉頭去吃臭豆腐
不知道為什麼 點臭豆腐的同時又點了米粉羹 明明知道它就是大腸麵線還是點了
臭豆腐吃起來帶汁 挺鮮的
最後到了白天的羅東夜市 為了完成昨天沒吃到的遺憾
可是阿灶伯沒開 不過包心粉圓人很少 送
買了個奇怪的宜蘭餅就去還車了
旅程本該就此結束 啟程返家 可怎奈HIPPO魂牽夢縈著宜蘭市的瓜仔雞麵
所以當我回過神的時候 我又出現在宜蘭火車站外
走上前一天走過的路 我跟宜蘭越來越熟悉
點了瓜仔雞麵後 順便到隔壁買了三十年老店愛玉冰
一旁的EASY SHOP店員聲嘶力竭的叫賣促銷 可憐它的大聲公沒有錄音功能
吃著的當間 一陣嗩吶聲 一旁的大馬路出現了出殯的隊伍......
結束瓜仔雞麵 接著吃信利號貓耳朵
...說什麼貓耳朵類似水晶餃 它就是水晶餃!!! 騙人也不是這個樣子
吃著吃著 EASY SHOP的店員又出現了 沿街叫賣 路過店家也進去給歐巴桑一張DM
兩人摸著渾圓的肚皮 坐上首都之星 回台北
--
宜蘭叫人猜不透的是 為什麼年輕人的機車都要拆後照鏡 ..... 後方來車很危險耶
2008年2月12日 星期二
圖書館自動化系統安裝----嘴砲
記得第一次用這個系統是去西嶺國小用的 之後陸陸續續的又用了幾次 最後又變成只有在用KOHA
總覺得應該記下來 做個紀念 雖然以後不會再用了 也可以當個青春的軌跡
原本的說明書是用IIS加Coldfusion來跑
不過普通電腦不會灌IIS 我在一次的機會下 研究出如何讓coldfusion在appserv下面跑
茲以為記
流程
1.基礎設施:windows作業系統+java runtime enviroment
(因為coldfusion的資料庫檔案瀏覽器要用JAVA開 不然會開不出來 不過還是可以直接貼檔案路徑)
1.1 下載圖書館軟體
2.安裝伺服器軟體
2.1 Appserv-win32-2.4.4a (注意版本,新版的MYSQL會變成UTF8...這個程式還是在用BIG5在跑)
2.2 Coldfusion4.5 (設定密碼及網路根目錄(預設值為appserv/www)
(4.5版是免費軟體 ㄎㄎ 不過專業版的話可以直接匯入國圖的資料)
2.3 從cfusion\bin複製ApacheModuleColdFusion.dll到appache\modules
(要讓APPSERV載入模組)
2.4 修改httpd.conf
2.4.1 在httpd.conf 裡面 搜尋LoadModule
新增一行加入 LoadModule coldfusion_module modules/ApacheModuleColdFusion.dll
2.4.2 在httpd.conf 裡面 搜尋AddModule
新增一行加入 AddModule mod_coldfusion.c
2.4.3 在httpd.conf 裡面 搜尋DirectoryIndex,於index.php3後空格新增 index.cfm
2.4.4 儲存檔案
2.4.5 重新啟動appche(程式集裡面restart appache server)
2.5 解壓縮library.rar至網路根目錄(預設值為appserv/www)
2.6 CF資料庫
2.6.1 開啟安裝首頁 程式集>Coldfusion>coldfusion express admintrator
(預設值為http://127.0.0.1/CFIDE/Administrator/index.cfm)
2.6.2 鍵入安裝密碼 (參考2.2)
2.6.3 點選ODBC連結(資料庫連結)
2.6.4 新增資料 Microsoft Access(persondata,discussdata,mediadata,exchangedata)
路徑位置 library/mdb/psrsondata.mdb (類推)
2.6.5 安裝完成
3.軟體操作
3.1 軟體說明書 http://www.hkes.hcc.edu.tw/teacher/wywang/index.htm
3.2 localhost/library/maintain/ 登入(IP)(預設a,a)
3.3 更改權限,新增管理者
3.4 編目
3.5 修改
3.6 讀者資料
4.由我跟怪胎陳共同開發的條碼製造機 http://green.lins.fju.edu.tw/~lisa/barcode/barcode.php
已經用3年了 不會改版 需事先下載3 of 9字型
請用IE開啟 不支援其他瀏覽器 條碼紙要用鶴屋的56格標籤紙
以上
有興趣想要在自己家裡面做圖書室的話 照著步驟來就可以了 ㄎㄎ
---
新的KOHA真是越來越花俏了 我上次用VMWARE已經成功的安裝過一次了 Z3950也是一次到位
不過實在是灌很久 OTZ 我想還是很難推廣吧 ㄎㄎ
---
我想以後應該再也不會用到了吧....這些都是我的青春....嗚呼 尚饗
總覺得應該記下來 做個紀念 雖然以後不會再用了 也可以當個青春的軌跡
原本的說明書是用IIS加Coldfusion來跑
不過普通電腦不會灌IIS 我在一次的機會下 研究出如何讓coldfusion在appserv下面跑
茲以為記
流程
1.基礎設施:windows作業系統+java runtime enviroment
(因為coldfusion的資料庫檔案瀏覽器要用JAVA開 不然會開不出來 不過還是可以直接貼檔案路徑)
1.1 下載圖書館軟體
2.安裝伺服器軟體
2.1 Appserv-win32-2.4.4a (注意版本,新版的MYSQL會變成UTF8...這個程式還是在用BIG5在跑)
2.2 Coldfusion4.5 (設定密碼及網路根目錄(預設值為appserv/www)
(4.5版是免費軟體 ㄎㄎ 不過專業版的話可以直接匯入國圖的資料)
2.3 從cfusion\bin複製ApacheModuleColdFusion.dll到appache\modules
(要讓APPSERV載入模組)
2.4 修改httpd.conf
2.4.1 在httpd.conf 裡面 搜尋LoadModule
新增一行加入 LoadModule coldfusion_module modules/ApacheModuleColdFusion.dll
2.4.2 在httpd.conf 裡面 搜尋AddModule
新增一行加入 AddModule mod_coldfusion.c
2.4.3 在httpd.conf 裡面 搜尋DirectoryIndex,於index.php3後空格新增 index.cfm
2.4.4 儲存檔案
2.4.5 重新啟動appche(程式集裡面restart appache server)
2.5 解壓縮library.rar至網路根目錄(預設值為appserv/www)
2.6 CF資料庫
2.6.1 開啟安裝首頁 程式集>Coldfusion>coldfusion express admintrator
(預設值為http://127.0.0.1/CFIDE/Administrator/index.cfm)
2.6.2 鍵入安裝密碼 (參考2.2)
2.6.3 點選ODBC連結(資料庫連結)
2.6.4 新增資料 Microsoft Access(persondata,discussdata,mediadata,exchangedata)
路徑位置 library/mdb/psrsondata.mdb (類推)
2.6.5 安裝完成
3.軟體操作
3.1 軟體說明書 http://www.hkes.hcc.edu.tw/teacher/wywang/index.htm
3.2 localhost/library/maintain/ 登入(IP)(預設a,a)
3.3 更改權限,新增管理者
3.4 編目
3.5 修改
3.6 讀者資料
4.由我跟怪胎陳共同開發的條碼製造機 http://green.lins.fju.edu.tw/~lisa/barcode/barcode.php
已經用3年了 不會改版 需事先下載3 of 9字型
請用IE開啟 不支援其他瀏覽器 條碼紙要用鶴屋的56格標籤紙
以上
有興趣想要在自己家裡面做圖書室的話 照著步驟來就可以了 ㄎㄎ
---
新的KOHA真是越來越花俏了 我上次用VMWARE已經成功的安裝過一次了 Z3950也是一次到位
不過實在是灌很久 OTZ 我想還是很難推廣吧 ㄎㄎ
---
我想以後應該再也不會用到了吧....這些都是我的青春....嗚呼 尚饗
2008年2月5日 星期二
新課表 ㄎㄎ
從放寒假開始
我已經點NTUINFO點的手都要抽筋了
成績那一欄總是全班成績未到 讓我整個人很火
沒想到大一查成績的度爛心情到了研究所依然一樣度爛
老是在等等等
等到今天 總算出了另外兩個很驚險的科目
一個是老師叫我改報告我都沒有改直接交的
另一個是我絞盡腦汁只能生出十頁報告的
剛剛好80分 真驚險 我一直很害怕看到69 65之類的詭異分數
我下學期會好好做報告的 我也會順便想想論文要寫什麼 雖然我整個沒有頭緒
我的新課表
圖書館建築-吳可久--是大學部的課 我想看看大學部長什麼樣 不過應該會退掉
圖書館與資訊社會-林奇秀--上學期被老師嚇跑 這學期我想試試看會不會又被嚇跑一次
公共圖書館研討-盧秀菊--聽說很猛 不知道究竟如何 不過只有5個人選 應該會被打爆
研究方法-林珊如--必修
讀者服務研討-陳書梅--必修
當代圖書館問題-范承源--選好玩的
結果我的必修課又開在晚上 ...在職班人少又不是我的錯 為什麼要我併班概括承受 哭哭
你知不知道我白天沒事做的話只會睡大頭覺啊 OTZ
喔開在師大有開一789的課 叫做資訊檢索 有沒有人想要跟我過去跟喔開敘敘舊
我想要跟老師說 "請你不要再說我脫褲子放屁了"
應該不至於太難吧 就讓我聽聽概論就好
我已經點NTUINFO點的手都要抽筋了
成績那一欄總是全班成績未到 讓我整個人很火
沒想到大一查成績的度爛心情到了研究所依然一樣度爛
老是在等等等
等到今天 總算出了另外兩個很驚險的科目
一個是老師叫我改報告我都沒有改直接交的
另一個是我絞盡腦汁只能生出十頁報告的
剛剛好80分 真驚險 我一直很害怕看到69 65之類的詭異分數
我下學期會好好做報告的 我也會順便想想論文要寫什麼 雖然我整個沒有頭緒
我的新課表
圖書館建築-吳可久--是大學部的課 我想看看大學部長什麼樣 不過應該會退掉
圖書館與資訊社會-林奇秀--上學期被老師嚇跑 這學期我想試試看會不會又被嚇跑一次
公共圖書館研討-盧秀菊--聽說很猛 不知道究竟如何 不過只有5個人選 應該會被打爆
研究方法-林珊如--必修
讀者服務研討-陳書梅--必修
當代圖書館問題-范承源--選好玩的
結果我的必修課又開在晚上 ...在職班人少又不是我的錯 為什麼要我併班概括承受 哭哭
你知不知道我白天沒事做的話只會睡大頭覺啊 OTZ
喔開在師大有開一789的課 叫做資訊檢索 有沒有人想要跟我過去跟喔開敘敘舊
我想要跟老師說 "請你不要再說我脫褲子放屁了"
應該不至於太難吧 就讓我聽聽概論就好
2008年1月22日 星期二
不知死活的期末報告
基於不知死活的原因
這學期我的期末報告我只用了一份
一份衝9學分 我想這需要很大的勇氣跟臉皮
當初這麼做 是因為有個老師說「老師不反對報告 一魚多吃啦」
這句話 激起了我內心最原始的惰性 我從學期初就開始幻想用一份報告吃九學分
然後我挑了個題目 叫做「語意網」semantic web
1/3號
前一天我還在中國期刊網裡尋尋覓覓 像在大海裡企求一根浮木般 想要抓住些什麼 最後還是什麼也沒有
第一次報告的時候 我根本是在慌慌張張的情況跑上台
講話也結結巴巴的 還好同學沒有把我轟下台 原因是 這個東西大家應該都搞的不是很懂
這明明就是是一個技術導向的東西 可我偏偏想以概念嘴砲的方式來詮釋它
所以死的很難看
1/14第二次報告 鑑於第一次的七零八落 不想再一次的丟臉 我思索了一般 將題目縮小到語意網的檢索效能
也就是比較透過語意網檢索以及傳統全文檢索兩者間的效能差異 幹 結果現在沒有人做 就只能打嘴砲了
結果就被老師糗這個題目太簡單 然後說什麼參考文獻可以找找台灣人的 阿台灣人就是都沒寫不然我找大陸的做什麼啦
我當然知道大陸仔權威度不高 可是他們人多啊!!! 人多好辦事你知不知道
而且我的重點又不在知識本體建構
本體建構可以另外再寫個20幾頁....
結果老師叫我改的部分我都沒改 然後我就交了 嗯
沒錯 我在找死
1/18第三次報告
報告的時候 之前聽過的同學都走了出去 那邊也這麼幹過的那個誰坐在座位上傻笑
罷了 也就是為了3學分而已 何苦彼此為難彼此?
到了最後 老師什麼也沒說 我就結束了這9學分的報告
我下次不會這樣了 挑題目也是學習的課題之一 命題必須要有前瞻性 研究性 範圍又不能太大
要在可處理的能力範圍內 貪多嚼不爛 如此而已
我現在又要去趕作業了 DEADLINE是01/23 我目前只有3頁
真刺激 ㄎㄎ
我的簡報檔
爛貨PDF下載 應該沒有人會點 我放爽的
以下是狗屁全文 可以略過
目次
壹、前言4
貳、語意網的階層架構5
一、語意網的階層5
二、語意網的結構6
1.XML6
2.RDF7
3.知識本體(Ontology)9
參、傳統的搜尋引擎9
一、傳統的搜尋引擎9
二、傳統搜尋引擎的架構10
肆、基於語意網基礎的搜尋引擎11
一、語意網搜尋引擎的目標以及功能11
二、基於語意網的搜尋引擎結構13
三、當前檢索語意網的搜尋引擎14
1、Swangler14
2、Swoogle16
伍、結論18
陸、參考文獻19
圖目錄
1圖一:語意網結構圖5
2圖二:Graphs and Webs: before RDF7
3圖三:Graphs and Webs: after RDF7
4圖四 RDF三元組範例8
5圖五 基於語意網的搜尋引擎結構13
6圖六:Swangler系統檢索流程14
7圖七 以純文字檢索的Swangle系統檢索流程15
8圖八 語意網搜尋引擎Swoogle的架構16
9圖九 Swoogle的檢索介面17
10圖10 Swoogle的檢索結果畫面17
壹、前言
目前的網際網路只是將網路當作載體,電腦對於網路資源的內容並無法理解。電腦在整個網際網路的功能之中只扮演了運送的角色:從遠端將資訊傳遞到本地,進而呈現在使用者的螢幕上。此一行為大大浪費了電腦本身所具有的運算能力。因此Tim Berners-Lee在90年代末期提出了語意網的概念,目的在於發展能夠讓機器讀取的資訊(Berners-Lee, Hendler, & Lassila, 2001)。
當前網際網路資訊大多由HTML語言所構成,其是由SGML標記語言發展而成,其功能在於資訊的呈現(display)。雖然人人都可以理解由瀏覽器呈現的資訊,但對於電腦而言其仍只是0與1的符號。既有的HTML對於資訊本身的描述只有在"title"部份,對於資訊的展現相當有限,並且不利於由電腦自動處理。因此語意網地基礎便是由XML(eXtensible Markup language)所構成,目的在於能夠表達資訊的內容,進而讓機器可以理解。
目前的網路搜尋引擎如GOOGLE等,雖然組織了大量的網路資源,但是其是建基於龐大的全文檢索之上,使用者只能以關鍵字比對的技術去取得其所需要的資訊。事實上而言,網路龐大的資訊量到目前為止仍然處於一種混亂的情況,而研究也指出網路搜尋引擎的精確率只有5%,因此唯有透過語意網將網路資源進行組織之後,資訊的取用才會真正的滿足使用者需求。而在語意網文件日漸成長的同時,必須要有一套高效率的檢索機制才能讓使用者有效率的取用語意網文件,因此有必要基於傳統的網路搜尋引擎來發展一適用於語意網時代的搜尋引擎。
貳、語意網的階層架構
一、語意網的階層
1圖一:語意網結構圖http://www.w3.org/2001/09/06-ecdl/slide17-0.html
首先語意網的底層是UNICODE以及URI,使用UNICODE字集目的在於能夠處理當前世界上所有的語言,而URI(Uniform Resource Identifier)統一資源辨識
是為了標示單一資源,目前常見的URL(Uniform Resource Locator)即是URI的一種。
第二層是由Xml+NameSpace+Xmlschema所構成,其負責從語法上表現資料的內容與結構,透過使用標準的標識語言將網路訊息的表現形式、資料結構和資訊內容分離。但因為XML只能表達資料的語法,而不能表達機器可理解的形式化語法,為此而導入了RDF結構。
第三層RDF+RDFschema:RDF是一種描述網路資源的一種語言,其目的是建立一種供多種後設資料標準共存的框架。RDF Schema使用一種機器可以理解的體系來定義描述資源的辭彙。為了滿足描述資訊的需要,RDFS允許使用者自行定義除了RDF基本的描述集合以外的特定領域的概念集合,意即本體字彙(Ontology)
第四層Ontology Vocabulary:該層是在RDFS基礎上定義的概念及其關係的抽象描述,用於描述特定領域的知識以及資訊與資訊間的關係,實現對詞彙表的擴展。在這一個層級使用者不僅可以定義概念亦可以定義概念之間豐富的關係。
第五層到第七層Logic、Proof、Trust:Logic負責提供公理和推理規則;Proof、Trust透過Proof交換以及數位簽章建立一定的信任關係。(羅慶雲 & 趙巾幗, 2007)
目前對於Logic、Proof、Trust等階層的研究上不是很多,但是語意網應用的最後關鍵便是透過邏輯判斷、事實驗正以及資訊信任從而提供代理人(agent)自動替使用者判斷資訊的可用性。
二、語意網的結構
1.XML
XML的優點在於允許使用者以標籤定義檔案的標記,並且可以從標籤的嵌套導引導出文件的結構。另外並將網路資源的內容和結構從格式分離出來,從而提供機器辨識的第一步。由於傳統的HTML標記的目的是檔的呈現方式,並非是檔的內容結構,唯有透過定義XML標籤才能夠使電腦能夠辨識檔的組織。
而其缺點在於其標籤的組合並沒有明確的關係,必須視個別應用而定。因此仍只有人才能夠讀取XML檔的語義。(Grigoris Antoniou, 2006)
XML標準只定義了語法結構,機器並無法理解XML標籤的內容。(Shah, Finin, & Joshi, 2002)
即使透過XML編碼資源,電腦仍依賴應用程式來判斷其語意內容(Ding et al., 2005)
因為經過XML組織過後的文件的資訊內容對於電腦仍是不可知的0與1的電子訊號,標籤與標籤彼此的關係並沒有被定義,所以其後便發展出RDF(S)來定義標籤彼此之間的關係。
2.RDF
傳統的HTML檔之間的關係只有連結(href),檔與檔之間的關係都是平行的,電腦沒有辦法去判斷文件與文件之間的關係,如圖一。而經過RDF框架描述之後,則可以清楚明確的將檔之間的關係釐清,如圖二。
2圖二:Graphs and Webs: before RDF
3圖三:Graphs and Webs: after RDF
RDF資源描述框架( resource description framework),是由 W3C(world wide web consortium)在XML的基礎上推薦的一種標準,是用於表達網際網路資源的資訊的語言,專門用於表達網路資源後設資料。RDF能夠定義概念以及概念間的關係,描述易被機器理解的資訊和知識,可用於資料探勘,為搜索引擎提供更強大的搜索功能;可用於編目,描述內容以及內容之間的關聯關係。
RDF解決的是如何採用 XML 標記語言惟一而無二義性地描述資源物件的問題。XML 並沒有預先提供任何關於資料的解釋,而 RDF是描述關於後設資料的一個模型,並給出資料的一些解釋,以此來增強後設資料的互通性。RDF本身並不規範語義,但是它為資源描述提供了一種通用框架,以定義反映特定需求的語義結構的能力。從這個意義上來說,RDF是一個開放的後設資料框架。 RDF提供一個資料模型支援對資料來源的快速彙整。RDF模型支援對網路資訊源和服務以及智慧應用的集成和統一的訪問,並用標準的機制去交換資料和處理不同的資料語意。(石翌軼, 宋自林, & 尹康銀, 2006)
RDF(資源描述框架) 提供了描述後設資料,而RDF Schema (RDFS)則是用來定義描述所用到的主體(subject) 、謂詞(predicate)及客體(object)的。可以用面向物件的思想來類比它們之間的關係,如果說 RDF是用來完成實際工作的物件,那麼 RDFS就是用來定義物件的類。RDF只提供了一種描述資源 →屬性 →屬性值的方法。其本身並沒有一種機制來定義這三元組,而RDFS可以完成這個工作。 RDFS定義了一套類和屬性來描述其他的類和屬性,進一步定義了某個資源描述(物件)是某個類的實例。而某個屬性是用來描述某個特定物件的,這個屬性的屬性值又是某個特定類的實例。(徐瑩, 徐福緣, & 李生琦, 2006)
而在RDF的組織之下所有的資源都被定意成一個三元組(triple)如下圖例:
4圖四 RDF三元組範例
三元組是由主體、屬性、客體三者所構成,在圖四中便是表達出網站” http://www.w3.org/home/Lassila”的Creator是Ora Lassila的概念模型。
3.知識本體(Ontology)
Greuber將知識本體(Ontology)定義為「概念模型的明確規範說明」,Neches等人將知識本體定義為「構成相關領域詞彙的基本術語和關係,以及利用這些術語和關係構成的規定這些詞彙外延的規則的定義」。
知識本體是經過規範化的有關領域中的各類標準術語詞彙的集合,並且這些術語詞彙都有明確的概念定義,集合的內部結構反映了術語間的各種體系關係以及術語間的聯繫。(竇玉萌 & 王孟龍, 2006)
知識本體呈現了兩種層面的知識架構
1.主題內的概念及子概念
2.概念間的關係與限制(Madalli, 2006)
知識本體的建構多依賴於領域專家定義其領域範圍內特定的術語,並且描述術語間彼此的關係。透過知識本體的建構可以讓電腦理解在語意網檔中各個節點(node)彼此的關係。
參、傳統的搜尋引擎
一、傳統的搜尋引擎
目前最受使用者歡迎的搜尋引擎GOOGLE採用的是以關鍵字檢索為基礎的技術。使用者輸入檢索關鍵字向搜索引擎提出查詢,搜索引擎根據關鍵字對網頁索引庫進行檢索,對檢索結果按照一定的演算法排序後傳回結果。其並不處理以及理解語意網檔中的標記。
使用基於傳統關鍵字檢索的搜尋引擎侷限性在於:
1、使用者只能使用關鍵字向搜索引擎表達其資訊需求,但是問題在於使用者的需求與關鍵字概念上的轉換往往難以明確表達。
2、搜索引擎不能理解自然語言。經過分析,用自然語言來描述對資訊的需求比用關鍵字準確得多,同時使用者也較容易做到。(曹二堂 & 劉玉林, 2006)
3、傳統的搜尋引擎無法理解字與字之間的關係(Yufei, Yuan, & Xiaotao, 2007)
4、傳統的網路資訊檢索是由任意查詢(ad-hoc query)去檢索固定的檔集,搜尋引擎在龐大的資料庫中進行關鍵字檢索。其準確率偏低,而且多檢索到不相關的文獻(Shah et al., 2002)。
5、當前的搜尋引擎以字的變形做為索引詞,其直接忽略標記的存在。而語意網的建立在標記的基礎上,因此現行的搜尋引擎並不適用於語意網檢索。
6、搜尋引擎檢索僅依賴於查詢詞與文件集的相關度。但是純文字並不適用於語意網的推論功能,因此必須透過自動轉換來製作語意呈現形式。(Finin, Mayfield, Joshi, Cost, & Fink, 2005)
7、因為語意網檔的標註跟網頁是分開的,所以傳統搜尋引擎的全文索引檢索並無法處理語意網文件。而語意網搜尋引擎不但將原始檔進行全文索引,並且也將語意標記(markup)製作索引。(Shah et al., 2002)
8、目前檢索技術並不適合索引及檢索語意標記,同時也無法利用語意標記加強文字檢索,同時傳統的文字檢索無法有效利用語意網的推論。(Mayfield & Finin, 2003)
二、傳統搜尋引擎的架構
當前的全文檢索的網路搜尋引擎的結構大致上分為四種,分別為Spider、Indexer、Searcher、使用者介面(user interface)。
Spider的功能在於從網際網路中發現以及搜尋資訊,同時定期更新已經搜尋過的資源,並刪除失效的連結。其檢索策略有兩種:由初始網址檢索所有的超連結或將網站分類蒐集。
Indexer的功能為分析Spider所蒐集的資訊,並從中抽取出能夠反映檔形式和內容的資訊做為索引值。其最終的目的在於描述檔案以及產生相關的索引表,而索引表的建置一般採用倒置檔(inverted file)。
Searcher的功能為於將使用者輸入的資訊與索引資料庫中的資訊進行比對
,並且快速的檢索出符合關鍵字要求的檔案,然後依照相關性將檢索結果輸出,同時提供使用者相關反饋機制。
使用者介面提供使用者與搜尋引擎間溝通的橋樑,其功能在於輸入查詢值、顯示檢索結果、提供相關回饋,其目的在於引導使用者方便的從搜尋引擎得到有效的資訊。(竇玉萌 & 王孟龍, 2006)
肆、基於語意網基礎的搜尋引擎
一、語意網搜尋引擎的目標以及功能
目前語意網的文件兩種產生的形式1.與傳統HTML結合的2.與HTML檔案分離的成對檔案,利用URI來辨識資源(Finin et al., 2005)。但是當前還未發展出可以處理同時具有HTML標籤以及語意標記的文件,因此語意網的搜尋引擎的檢索對象是純粹的語意網文件。
而檢索語意網文件的目的主要基於以下幾點:首先,語意網文件的內容是為了能讓機器能夠處理而產生的,雖然語意註記以及標示可以讓人很快找到所需的資訊,但是最終的目的是提供代理人進行運算。另外語意網半結構式的資訊(RDF)需要有效索引及檢索科技的結合才能夠有效的檢索取用。除此之外,語意網文件包含了許多面向,搜尋引擎必須要具有思考推論的功能,並且處理其他的後設資料。傳統的搜尋引擎並沒有理解文獻內容,也無法提供語意網文件的檢索。(Ding et al., 2005)
而為了要達到檢索語意文件的目標,基於語意網的檢索框架必須支援:
1.同時支援檢索以及推論過程。
2.可以用單字、語意標記做為索引詞。
3.網路搜尋必須依賴現有的大範圍搜尋引擎。
4.推論與檢索必須緊密結合,兩者必須相輔相成。(Finin et al., 2005)
同時具備上述四點的搜尋引擎才能完全利用語意網強大的結構能力,並進一步改善使用者的檢索效率。
而基於語意網的搜尋引擎的可以提供以下功能:
1.標籤檢索:可以由基於關鍵字檢索的介面提供XML的標籤檢索,並且提供多個相關標籤的輸入或者是提供下拉式選單。
2.支援隱性資訊的查詢:傳統搜尋引擎無法辨識FLASH、PDF等檔案格式的內容,基於XML的結構基礎可以描述任何形式的資源並檢索之。
3.過濾以關鍵字優化的網頁(SEO):由於語意網採用XML標籤,網頁設計者必須依照標準加入XML標籤來表現網頁主題,若是任意改變標籤內容會造成語意理解上的困難,會自動被搜尋引擎過濾掉。因此以關鍵字堆砌而產生的無效檢索,在語意網中是看不到的。
4.利用既有的全文資訊檢索相關資訊:透過已知的結構化檔可以檢索擁有相同性質的資訊。
5.分類顯示檢索結果:在使用者提出查詢之後,可以利用既有的知識本體框架將檢索結果進行分類,讓使用者可以進一步的篩選資訊。(竇玉萌 & 王孟龍, 2006)
二、基於語意網的搜尋引擎結構
5圖五 基於語意網的搜尋引擎結構
基於語意網搜尋引擎結構如圖五所示,共分為五個部份,分別為:
1.輸入及對映本體:將不同本體但是相關的概念做連結,類似索引典中的Related term的製作,目的在於聚集所有相關的概念。
2.網路爬梳(SPIDER):搜尋並下載網路上的資訊,類似傳統搜尋引擎之功能,目的是為了製作索引。
3.索引:將已下載的網路資訊以字為單元做索引,並從而提供檢索。
4.本體索引:將先前所製作的索引詞與本體中的概念連結,並從而提供檢索。
5.前端:提供使用者檢索介面,使用者可以使用基於普通索引的關鍵字檢索或是基於本體索引的本體概念檢索(Köhler, Philippi, Specht, & Rüegg, 2006)
三、當前檢索語意網的搜尋引擎
目前基於語意網的搜尋引擎有以下三種:第一種系統框架是OWLIR,它接受以任意文字和結構化欄位的查詢。第二種原型系統是Swangler,它是對傳統的 RDF文件加注語意標記,然後由像 Google 一般的傳統搜索引擎索引。第三種是Swoogle ,它是對 RDF文件基於網路爬梳(SPIDER)的檢索系統。它利用網路機器人程式搜索 RDF檔同時把其中後設資料加入到資料庫中。(江克勤, 張玉州, & 王一賓, 2007)。以下就Swangler以及Swoogle進行介紹
1、Swangler
6圖六:Swangler系統檢索流程
Swangler系統檢索流程如圖五所示,共可分為六個步驟,分別為:
1.提出語意查詢:提出具有語意編碼的查詢,而非以傳統的任意文字檢索
2.推論引擎運作:將查詢句進行有限度的語意延伸,如同以關鍵字檢索時傳統的索引典擴充,並從而產生用於檢索的語意標記描述
3.將語意標記轉換成普通的文字(swangling)
4.將文字查詢傳到多個傳統網路搜尋引擎
5.傳統搜尋引擎產生排序的網頁,並且由推論引擎作出數量上的刪減
6.推論引擎將結果做出過濾
7.傳回至使用者介面。(Finin et al., 2005)
7圖七 以純文字檢索的Swangle系統檢索流程
而除了上述以結構化的語意標記進行檢索外,Swangle系統亦提供了以任意文字檢索的功能(free text),其流程如圖六,分別為
1.純文字檢索經由SWANGLED強化後直接傳送到傳統搜尋引擎
2.抽出器將文字從檢索頁面抽出
3.透過整合、翻譯、認證等功能過濾資訊
4.合併抽出的文字做為相關回饋之後的檢索值。(Finin et al., 2005)
2、Swoogle
8圖八 語意網搜尋引擎Swoogle的架構
Swoogle主要分成四個架構,如圖八所示,分別為:
1.語意網文件探索:檢索並更新潛在的語意網檔,以基於GOOGLE檢索服務的機器人檢索潛在網頁,並以檔附檔名作為限制(如RSS、RDF)。另外亦發展Focused Crawler(專注爬梳),以使用者登記的語意網檔分析與該語意網檔的相關節點。
2.後設資料建構:製作快取,並基於語法與語意描述語意網檔。首先是分析檔的語言特徵,分別從編碼、語言等角度進行分析。其次是進行RDF統計,將檔中所包含的RDF節點進行數量上的統計。再來是知識本體標註,標註出包含檔的知識本體。.最後是分析語意網檔彼此之間的關係,由於知識本體間具有多樣性的關係,必須將其標示出來才有利於文件的檢索。其關係可分為某本體的延伸、某本體的輸入、某本體的前一版本等。
3.資料分析:以語意網快取以及後設資料分析語意網檔,如提供檔分類、檔排名以及製作索引。其給予文件的排名是由Google的PageRank所激發的靈感。PageRank計算HTML網頁中的內部連結以及外部連結的比率及數量並以此給予各個網頁排名,但是語意網文件彼此的關係不再是傳統的超連結關係,因此無法將相同的演算法套用在語意網文件上。但是基於相同的概念,Swoogle是以Rational Random Surfer模型分析語意網文件節點以及連結的關係,從而給予文件排名。
4.索引以及檢索:使用SIRE的客制化索引與檢索引擎,提供N-gram及單字的檢索,並使用TF/IDF餘弦模型計算相似度。(Ding et al., 2004)
5.介面:提供使用者及代理人檢索的檢索介面
以下就Swoogle搜尋引擎的檢索介面及檢索結果進行介紹
9圖九 Swoogle的檢索介面
10 圖10 Swoogle的檢索結果畫面
Swoogle具有類似Google的介面如圖九,提供一文字欄位(text bar)讓使用者鍵入關鍵字並檢索之,欄位上方並提供檢索範圍的選擇。而其檢索結果則如圖10所示,輸出符合鍵入關鍵字的檢索結果,並依照先前語意網文件的排名給予排序。而其單筆資料則提供了文件中出現關鍵字的部份段落、檔案類型、檢索日期、檔案大小、Swoogle對於語意網文件所製作的後設資料以及快取檔案。
伍、結論
因為網路資源的爆炸性成長,大量的資訊造成取用上的障礙,雖然搜尋引擎如GOOGLE在目前滿足了大多數使用者的需求,可是就本質而言,全文檢索對於大量且無序的網路資源基本上是效率極低的,並且檢索結果也多是不相關的文件。
語意網的發想便是為了組織網路上的資源而生,同時也是為了利用僅被當作載體的電腦運算能力。其目標是將所有的網頁以有組織的方式連結起來,並且提供代理人自動驗證演算的能力,進而可以替人進行簡單的判斷。
目前對於語意網檢索的研究多是基於實驗室的小規模實驗集,仍然無法完全呈現真實世界的現實情況。此一問題仍待語意網文件大量產出過後,方能擁有一大規模的實驗測試集。
筆者在研究伊始本是想要就傳統搜尋引擎的檢索效能以及基於語意標註的語意檢索上兩者之間的差異性,但是在檢索既有的文獻之後,發現目前尚無對於此一議題的研究。雖然語意網的前提是經過組織後的網路資源,勢必會比目前傳統的無序的全文資料提供更好的檢索效率,但是仍有必要進一步驗證語意標註及關鍵字檢索彼此之間的優劣。但囿於當前相關的資訊過少,因此調整研究方向為提供語意網文件檢索的搜尋引擎。其與傳統搜尋引擎的不同點在於對於語意標註的檢索及索引,其目的在於提供研究人員檢索到適合的知識本體或RDF檔,避免重複製作相同領域的知識本體,但是對其功能並不包括以語意標記強化文字檢索。
因此未來研究的方向應該是以基於知識本體的自動化以及語意網文件的自動化的基礎,以龐大的測試資料集為前提下,驗證傳統的全文檢索搜尋引擎以及基於語意標記的搜尋引擎彼此之間的檢索效能及滿足使用者需求兩者程度上的差異。
陸、參考文獻
Berners-Lee, T., Hendler, J., & Lassila, O. (2001). The semantic Web. Scientific American, 284(5), 28-37.
Ding, L., Finin, T., Joshi, A., Pan, R., Cost, R. S., Peng, Y., et al. (2004). Swoogle: A Search and Metadata Engine for the Semantic Web. Proceedings of the Thirteenth ACM Conference on Information and Knowledge Management.
Ding, L., Finin, T., Joshi, A., Peng, Y., Pan, R., & Reddivari, P. (2005). Search on the Semantic Web. Computer, 38(10), 62-69.
Finin, T., Mayfield, J., Joshi, A., Cost, R. S., & Fink, C. (2005). Information Retrieval and the Semantic Web. System Sciences, 2005. HICSS'05. Proceedings of the 38th Annual Hawaii International Conference on, 113a-113a.
Grigoris Antoniou, F. v. H. (2006). 語意網技術導論 (初版 ed.). 臺北市: 碁峰資訊.
Köhler, J., Philippi, S., Specht, M., & Rüegg, A. (2006). Ontology based text indexing and querying for the semantic web. Knowledge-Based Systems, 19(8), 744-754.
Madalli, D. P. (2006). ONTOLOGIES AS KNOWLEDGE STRUCTURES FOR SEMANTIC RETRIEVAL. Information Studies, 12(4), 205-212.
Mayfield, J., & Finin, T. (2003). Information retrieval on the Semantic Web: Integrating inference and retrieval. SIGIR Workshop on the Semantic Web, Toronto, 1.
Shah, U., Finin, T., & Joshi, A. (2002). Information retrieval on the semantic web. Proceedings of the eleventh international conference on Information and knowledge management, 461-468.
Swoogle, http://swoogle.umbc.edu/.
Yufei, L., Yuan, W., & Xiaotao, H. (2007). A Relation-Based Search Engine in Semantic Web, IEEE Transactions on Knowledge & Data Engineering (Vol. 19, pp. 273-281).
石翌軼, 宋自林, & 尹康銀. (2006). 一種基於語義的Web資料搜索引擎方法研究. 山東大學學報(理學版)(03).
江克勤, 張玉州, & 王一賓. (2007). 基於語義的Web資訊檢索. 電腦技術與發展(01).
徐瑩, 徐福緣, & 李生琦. (2006). 基於語義的智慧檢索在供需網中的應用. 上海理工大學學報(03).
曹二堂, & 劉玉林. (2006). 一種基於語義理解的元搜索引擎的研究. 電腦工程(07).
虞為, 曹加恒, 曾承, 黃敏, & 陳俊鵬. (2007). 基於語義索引詞的語義網資訊檢索模型. 電腦工程(03).
竇玉萌, & 王孟龍. (2006). 面向語義Web的搜索引擎構想. 情報探索(07).
羅慶雲, & 趙巾幗. (2007). 語義化Web的理論基礎與技術基礎. 甘肅聯合大學學報(自然科學版)(05).
這學期我的期末報告我只用了一份
一份衝9學分 我想這需要很大的勇氣跟臉皮
當初這麼做 是因為有個老師說「老師不反對報告 一魚多吃啦」
這句話 激起了我內心最原始的惰性 我從學期初就開始幻想用一份報告吃九學分
然後我挑了個題目 叫做「語意網」semantic web
1/3號
前一天我還在中國期刊網裡尋尋覓覓 像在大海裡企求一根浮木般 想要抓住些什麼 最後還是什麼也沒有
第一次報告的時候 我根本是在慌慌張張的情況跑上台
講話也結結巴巴的 還好同學沒有把我轟下台 原因是 這個東西大家應該都搞的不是很懂
這明明就是是一個技術導向的東西 可我偏偏想以概念嘴砲的方式來詮釋它
所以死的很難看
1/14第二次報告 鑑於第一次的七零八落 不想再一次的丟臉 我思索了一般 將題目縮小到語意網的檢索效能
也就是比較透過語意網檢索以及傳統全文檢索兩者間的效能差異 幹 結果現在沒有人做 就只能打嘴砲了
結果就被老師糗這個題目太簡單 然後說什麼參考文獻可以找找台灣人的 阿台灣人就是都沒寫不然我找大陸的做什麼啦
我當然知道大陸仔權威度不高 可是他們人多啊!!! 人多好辦事你知不知道
而且我的重點又不在知識本體建構
本體建構可以另外再寫個20幾頁....
結果老師叫我改的部分我都沒改 然後我就交了 嗯
沒錯 我在找死
1/18第三次報告
報告的時候 之前聽過的同學都走了出去 那邊也這麼幹過的那個誰坐在座位上傻笑
罷了 也就是為了3學分而已 何苦彼此為難彼此?
到了最後 老師什麼也沒說 我就結束了這9學分的報告
我下次不會這樣了 挑題目也是學習的課題之一 命題必須要有前瞻性 研究性 範圍又不能太大
要在可處理的能力範圍內 貪多嚼不爛 如此而已
我現在又要去趕作業了 DEADLINE是01/23 我目前只有3頁
真刺激 ㄎㄎ
我的簡報檔

爛貨PDF下載 應該沒有人會點 我放爽的
以下是狗屁全文 可以略過
目次
壹、前言4
貳、語意網的階層架構5
一、語意網的階層5
二、語意網的結構6
1.XML6
2.RDF7
3.知識本體(Ontology)9
參、傳統的搜尋引擎9
一、傳統的搜尋引擎9
二、傳統搜尋引擎的架構10
肆、基於語意網基礎的搜尋引擎11
一、語意網搜尋引擎的目標以及功能11
二、基於語意網的搜尋引擎結構13
三、當前檢索語意網的搜尋引擎14
1、Swangler14
2、Swoogle16
伍、結論18
陸、參考文獻19
圖目錄
1圖一:語意網結構圖5
2圖二:Graphs and Webs: before RDF7
3圖三:Graphs and Webs: after RDF7
4圖四 RDF三元組範例8
5圖五 基於語意網的搜尋引擎結構13
6圖六:Swangler系統檢索流程14
7圖七 以純文字檢索的Swangle系統檢索流程15
8圖八 語意網搜尋引擎Swoogle的架構16
9圖九 Swoogle的檢索介面17
10圖10 Swoogle的檢索結果畫面17
壹、前言
目前的網際網路只是將網路當作載體,電腦對於網路資源的內容並無法理解。電腦在整個網際網路的功能之中只扮演了運送的角色:從遠端將資訊傳遞到本地,進而呈現在使用者的螢幕上。此一行為大大浪費了電腦本身所具有的運算能力。因此Tim Berners-Lee在90年代末期提出了語意網的概念,目的在於發展能夠讓機器讀取的資訊(Berners-Lee, Hendler, & Lassila, 2001)。
當前網際網路資訊大多由HTML語言所構成,其是由SGML標記語言發展而成,其功能在於資訊的呈現(display)。雖然人人都可以理解由瀏覽器呈現的資訊,但對於電腦而言其仍只是0與1的符號。既有的HTML對於資訊本身的描述只有在"title"部份,對於資訊的展現相當有限,並且不利於由電腦自動處理。因此語意網地基礎便是由XML(eXtensible Markup language)所構成,目的在於能夠表達資訊的內容,進而讓機器可以理解。
目前的網路搜尋引擎如GOOGLE等,雖然組織了大量的網路資源,但是其是建基於龐大的全文檢索之上,使用者只能以關鍵字比對的技術去取得其所需要的資訊。事實上而言,網路龐大的資訊量到目前為止仍然處於一種混亂的情況,而研究也指出網路搜尋引擎的精確率只有5%,因此唯有透過語意網將網路資源進行組織之後,資訊的取用才會真正的滿足使用者需求。而在語意網文件日漸成長的同時,必須要有一套高效率的檢索機制才能讓使用者有效率的取用語意網文件,因此有必要基於傳統的網路搜尋引擎來發展一適用於語意網時代的搜尋引擎。
貳、語意網的階層架構
一、語意網的階層
1圖一:語意網結構圖http://www.w3.org/2001/09/06-ecdl/slide17-0.html
首先語意網的底層是UNICODE以及URI,使用UNICODE字集目的在於能夠處理當前世界上所有的語言,而URI(Uniform Resource Identifier)統一資源辨識
是為了標示單一資源,目前常見的URL(Uniform Resource Locator)即是URI的一種。
第二層是由Xml+NameSpace+Xmlschema所構成,其負責從語法上表現資料的內容與結構,透過使用標準的標識語言將網路訊息的表現形式、資料結構和資訊內容分離。但因為XML只能表達資料的語法,而不能表達機器可理解的形式化語法,為此而導入了RDF結構。
第三層RDF+RDFschema:RDF是一種描述網路資源的一種語言,其目的是建立一種供多種後設資料標準共存的框架。RDF Schema使用一種機器可以理解的體系來定義描述資源的辭彙。為了滿足描述資訊的需要,RDFS允許使用者自行定義除了RDF基本的描述集合以外的特定領域的概念集合,意即本體字彙(Ontology)
第四層Ontology Vocabulary:該層是在RDFS基礎上定義的概念及其關係的抽象描述,用於描述特定領域的知識以及資訊與資訊間的關係,實現對詞彙表的擴展。在這一個層級使用者不僅可以定義概念亦可以定義概念之間豐富的關係。
第五層到第七層Logic、Proof、Trust:Logic負責提供公理和推理規則;Proof、Trust透過Proof交換以及數位簽章建立一定的信任關係。(羅慶雲 & 趙巾幗, 2007)
目前對於Logic、Proof、Trust等階層的研究上不是很多,但是語意網應用的最後關鍵便是透過邏輯判斷、事實驗正以及資訊信任從而提供代理人(agent)自動替使用者判斷資訊的可用性。
二、語意網的結構
1.XML
XML的優點在於允許使用者以標籤定義檔案的標記,並且可以從標籤的嵌套導引導出文件的結構。另外並將網路資源的內容和結構從格式分離出來,從而提供機器辨識的第一步。由於傳統的HTML標記的目的是檔的呈現方式,並非是檔的內容結構,唯有透過定義XML標籤才能夠使電腦能夠辨識檔的組織。
而其缺點在於其標籤的組合並沒有明確的關係,必須視個別應用而定。因此仍只有人才能夠讀取XML檔的語義。(Grigoris Antoniou, 2006)
XML標準只定義了語法結構,機器並無法理解XML標籤的內容。(Shah, Finin, & Joshi, 2002)
即使透過XML編碼資源,電腦仍依賴應用程式來判斷其語意內容(Ding et al., 2005)
因為經過XML組織過後的文件的資訊內容對於電腦仍是不可知的0與1的電子訊號,標籤與標籤彼此的關係並沒有被定義,所以其後便發展出RDF(S)來定義標籤彼此之間的關係。
2.RDF
傳統的HTML檔之間的關係只有連結(href),檔與檔之間的關係都是平行的,電腦沒有辦法去判斷文件與文件之間的關係,如圖一。而經過RDF框架描述之後,則可以清楚明確的將檔之間的關係釐清,如圖二。
2圖二:Graphs and Webs: before RDF
3圖三:Graphs and Webs: after RDF
RDF資源描述框架( resource description framework),是由 W3C(world wide web consortium)在XML的基礎上推薦的一種標準,是用於表達網際網路資源的資訊的語言,專門用於表達網路資源後設資料。RDF能夠定義概念以及概念間的關係,描述易被機器理解的資訊和知識,可用於資料探勘,為搜索引擎提供更強大的搜索功能;可用於編目,描述內容以及內容之間的關聯關係。
RDF解決的是如何採用 XML 標記語言惟一而無二義性地描述資源物件的問題。XML 並沒有預先提供任何關於資料的解釋,而 RDF是描述關於後設資料的一個模型,並給出資料的一些解釋,以此來增強後設資料的互通性。RDF本身並不規範語義,但是它為資源描述提供了一種通用框架,以定義反映特定需求的語義結構的能力。從這個意義上來說,RDF是一個開放的後設資料框架。 RDF提供一個資料模型支援對資料來源的快速彙整。RDF模型支援對網路資訊源和服務以及智慧應用的集成和統一的訪問,並用標準的機制去交換資料和處理不同的資料語意。(石翌軼, 宋自林, & 尹康銀, 2006)
RDF(資源描述框架) 提供了描述後設資料,而RDF Schema (RDFS)則是用來定義描述所用到的主體(subject) 、謂詞(predicate)及客體(object)的。可以用面向物件的思想來類比它們之間的關係,如果說 RDF是用來完成實際工作的物件,那麼 RDFS就是用來定義物件的類。RDF只提供了一種描述資源 →屬性 →屬性值的方法。其本身並沒有一種機制來定義這三元組,而RDFS可以完成這個工作。 RDFS定義了一套類和屬性來描述其他的類和屬性,進一步定義了某個資源描述(物件)是某個類的實例。而某個屬性是用來描述某個特定物件的,這個屬性的屬性值又是某個特定類的實例。(徐瑩, 徐福緣, & 李生琦, 2006)
而在RDF的組織之下所有的資源都被定意成一個三元組(triple)如下圖例:
4圖四 RDF三元組範例
三元組是由主體、屬性、客體三者所構成,在圖四中便是表達出網站” http://www.w3.org/home/Lassila”的Creator是Ora Lassila的概念模型。
3.知識本體(Ontology)
Greuber將知識本體(Ontology)定義為「概念模型的明確規範說明」,Neches等人將知識本體定義為「構成相關領域詞彙的基本術語和關係,以及利用這些術語和關係構成的規定這些詞彙外延的規則的定義」。
知識本體是經過規範化的有關領域中的各類標準術語詞彙的集合,並且這些術語詞彙都有明確的概念定義,集合的內部結構反映了術語間的各種體系關係以及術語間的聯繫。(竇玉萌 & 王孟龍, 2006)
知識本體呈現了兩種層面的知識架構
1.主題內的概念及子概念
2.概念間的關係與限制(Madalli, 2006)
知識本體的建構多依賴於領域專家定義其領域範圍內特定的術語,並且描述術語間彼此的關係。透過知識本體的建構可以讓電腦理解在語意網檔中各個節點(node)彼此的關係。
參、傳統的搜尋引擎
一、傳統的搜尋引擎
目前最受使用者歡迎的搜尋引擎GOOGLE採用的是以關鍵字檢索為基礎的技術。使用者輸入檢索關鍵字向搜索引擎提出查詢,搜索引擎根據關鍵字對網頁索引庫進行檢索,對檢索結果按照一定的演算法排序後傳回結果。其並不處理以及理解語意網檔中的標記。
使用基於傳統關鍵字檢索的搜尋引擎侷限性在於:
1、使用者只能使用關鍵字向搜索引擎表達其資訊需求,但是問題在於使用者的需求與關鍵字概念上的轉換往往難以明確表達。
2、搜索引擎不能理解自然語言。經過分析,用自然語言來描述對資訊的需求比用關鍵字準確得多,同時使用者也較容易做到。(曹二堂 & 劉玉林, 2006)
3、傳統的搜尋引擎無法理解字與字之間的關係(Yufei, Yuan, & Xiaotao, 2007)
4、傳統的網路資訊檢索是由任意查詢(ad-hoc query)去檢索固定的檔集,搜尋引擎在龐大的資料庫中進行關鍵字檢索。其準確率偏低,而且多檢索到不相關的文獻(Shah et al., 2002)。
5、當前的搜尋引擎以字的變形做為索引詞,其直接忽略標記的存在。而語意網的建立在標記的基礎上,因此現行的搜尋引擎並不適用於語意網檢索。
6、搜尋引擎檢索僅依賴於查詢詞與文件集的相關度。但是純文字並不適用於語意網的推論功能,因此必須透過自動轉換來製作語意呈現形式。(Finin, Mayfield, Joshi, Cost, & Fink, 2005)
7、因為語意網檔的標註跟網頁是分開的,所以傳統搜尋引擎的全文索引檢索並無法處理語意網文件。而語意網搜尋引擎不但將原始檔進行全文索引,並且也將語意標記(markup)製作索引。(Shah et al., 2002)
8、目前檢索技術並不適合索引及檢索語意標記,同時也無法利用語意標記加強文字檢索,同時傳統的文字檢索無法有效利用語意網的推論。(Mayfield & Finin, 2003)
二、傳統搜尋引擎的架構
當前的全文檢索的網路搜尋引擎的結構大致上分為四種,分別為Spider、Indexer、Searcher、使用者介面(user interface)。
Spider的功能在於從網際網路中發現以及搜尋資訊,同時定期更新已經搜尋過的資源,並刪除失效的連結。其檢索策略有兩種:由初始網址檢索所有的超連結或將網站分類蒐集。
Indexer的功能為分析Spider所蒐集的資訊,並從中抽取出能夠反映檔形式和內容的資訊做為索引值。其最終的目的在於描述檔案以及產生相關的索引表,而索引表的建置一般採用倒置檔(inverted file)。
Searcher的功能為於將使用者輸入的資訊與索引資料庫中的資訊進行比對
,並且快速的檢索出符合關鍵字要求的檔案,然後依照相關性將檢索結果輸出,同時提供使用者相關反饋機制。
使用者介面提供使用者與搜尋引擎間溝通的橋樑,其功能在於輸入查詢值、顯示檢索結果、提供相關回饋,其目的在於引導使用者方便的從搜尋引擎得到有效的資訊。(竇玉萌 & 王孟龍, 2006)
肆、基於語意網基礎的搜尋引擎
一、語意網搜尋引擎的目標以及功能
目前語意網的文件兩種產生的形式1.與傳統HTML結合的2.與HTML檔案分離的成對檔案,利用URI來辨識資源(Finin et al., 2005)。但是當前還未發展出可以處理同時具有HTML標籤以及語意標記的文件,因此語意網的搜尋引擎的檢索對象是純粹的語意網文件。
而檢索語意網文件的目的主要基於以下幾點:首先,語意網文件的內容是為了能讓機器能夠處理而產生的,雖然語意註記以及標示可以讓人很快找到所需的資訊,但是最終的目的是提供代理人進行運算。另外語意網半結構式的資訊(RDF)需要有效索引及檢索科技的結合才能夠有效的檢索取用。除此之外,語意網文件包含了許多面向,搜尋引擎必須要具有思考推論的功能,並且處理其他的後設資料。傳統的搜尋引擎並沒有理解文獻內容,也無法提供語意網文件的檢索。(Ding et al., 2005)
而為了要達到檢索語意文件的目標,基於語意網的檢索框架必須支援:
1.同時支援檢索以及推論過程。
2.可以用單字、語意標記做為索引詞。
3.網路搜尋必須依賴現有的大範圍搜尋引擎。
4.推論與檢索必須緊密結合,兩者必須相輔相成。(Finin et al., 2005)
同時具備上述四點的搜尋引擎才能完全利用語意網強大的結構能力,並進一步改善使用者的檢索效率。
而基於語意網的搜尋引擎的可以提供以下功能:
1.標籤檢索:可以由基於關鍵字檢索的介面提供XML的標籤檢索,並且提供多個相關標籤的輸入或者是提供下拉式選單。
2.支援隱性資訊的查詢:傳統搜尋引擎無法辨識FLASH、PDF等檔案格式的內容,基於XML的結構基礎可以描述任何形式的資源並檢索之。
3.過濾以關鍵字優化的網頁(SEO):由於語意網採用XML標籤,網頁設計者必須依照標準加入XML標籤來表現網頁主題,若是任意改變標籤內容會造成語意理解上的困難,會自動被搜尋引擎過濾掉。因此以關鍵字堆砌而產生的無效檢索,在語意網中是看不到的。
4.利用既有的全文資訊檢索相關資訊:透過已知的結構化檔可以檢索擁有相同性質的資訊。
5.分類顯示檢索結果:在使用者提出查詢之後,可以利用既有的知識本體框架將檢索結果進行分類,讓使用者可以進一步的篩選資訊。(竇玉萌 & 王孟龍, 2006)
二、基於語意網的搜尋引擎結構
5圖五 基於語意網的搜尋引擎結構
基於語意網搜尋引擎結構如圖五所示,共分為五個部份,分別為:
1.輸入及對映本體:將不同本體但是相關的概念做連結,類似索引典中的Related term的製作,目的在於聚集所有相關的概念。
2.網路爬梳(SPIDER):搜尋並下載網路上的資訊,類似傳統搜尋引擎之功能,目的是為了製作索引。
3.索引:將已下載的網路資訊以字為單元做索引,並從而提供檢索。
4.本體索引:將先前所製作的索引詞與本體中的概念連結,並從而提供檢索。
5.前端:提供使用者檢索介面,使用者可以使用基於普通索引的關鍵字檢索或是基於本體索引的本體概念檢索(Köhler, Philippi, Specht, & Rüegg, 2006)
三、當前檢索語意網的搜尋引擎
目前基於語意網的搜尋引擎有以下三種:第一種系統框架是OWLIR,它接受以任意文字和結構化欄位的查詢。第二種原型系統是Swangler,它是對傳統的 RDF文件加注語意標記,然後由像 Google 一般的傳統搜索引擎索引。第三種是Swoogle ,它是對 RDF文件基於網路爬梳(SPIDER)的檢索系統。它利用網路機器人程式搜索 RDF檔同時把其中後設資料加入到資料庫中。(江克勤, 張玉州, & 王一賓, 2007)。以下就Swangler以及Swoogle進行介紹
1、Swangler
6圖六:Swangler系統檢索流程
Swangler系統檢索流程如圖五所示,共可分為六個步驟,分別為:
1.提出語意查詢:提出具有語意編碼的查詢,而非以傳統的任意文字檢索
2.推論引擎運作:將查詢句進行有限度的語意延伸,如同以關鍵字檢索時傳統的索引典擴充,並從而產生用於檢索的語意標記描述
3.將語意標記轉換成普通的文字(swangling)
4.將文字查詢傳到多個傳統網路搜尋引擎
5.傳統搜尋引擎產生排序的網頁,並且由推論引擎作出數量上的刪減
6.推論引擎將結果做出過濾
7.傳回至使用者介面。(Finin et al., 2005)
7圖七 以純文字檢索的Swangle系統檢索流程
而除了上述以結構化的語意標記進行檢索外,Swangle系統亦提供了以任意文字檢索的功能(free text),其流程如圖六,分別為
1.純文字檢索經由SWANGLED強化後直接傳送到傳統搜尋引擎
2.抽出器將文字從檢索頁面抽出
3.透過整合、翻譯、認證等功能過濾資訊
4.合併抽出的文字做為相關回饋之後的檢索值。(Finin et al., 2005)
2、Swoogle
8圖八 語意網搜尋引擎Swoogle的架構
Swoogle主要分成四個架構,如圖八所示,分別為:
1.語意網文件探索:檢索並更新潛在的語意網檔,以基於GOOGLE檢索服務的機器人檢索潛在網頁,並以檔附檔名作為限制(如RSS、RDF)。另外亦發展Focused Crawler(專注爬梳),以使用者登記的語意網檔分析與該語意網檔的相關節點。
2.後設資料建構:製作快取,並基於語法與語意描述語意網檔。首先是分析檔的語言特徵,分別從編碼、語言等角度進行分析。其次是進行RDF統計,將檔中所包含的RDF節點進行數量上的統計。再來是知識本體標註,標註出包含檔的知識本體。.最後是分析語意網檔彼此之間的關係,由於知識本體間具有多樣性的關係,必須將其標示出來才有利於文件的檢索。其關係可分為某本體的延伸、某本體的輸入、某本體的前一版本等。
3.資料分析:以語意網快取以及後設資料分析語意網檔,如提供檔分類、檔排名以及製作索引。其給予文件的排名是由Google的PageRank所激發的靈感。PageRank計算HTML網頁中的內部連結以及外部連結的比率及數量並以此給予各個網頁排名,但是語意網文件彼此的關係不再是傳統的超連結關係,因此無法將相同的演算法套用在語意網文件上。但是基於相同的概念,Swoogle是以Rational Random Surfer模型分析語意網文件節點以及連結的關係,從而給予文件排名。
4.索引以及檢索:使用SIRE的客制化索引與檢索引擎,提供N-gram及單字的檢索,並使用TF/IDF餘弦模型計算相似度。(Ding et al., 2004)
5.介面:提供使用者及代理人檢索的檢索介面
以下就Swoogle搜尋引擎的檢索介面及檢索結果進行介紹
9圖九 Swoogle的檢索介面
10 圖10 Swoogle的檢索結果畫面
Swoogle具有類似Google的介面如圖九,提供一文字欄位(text bar)讓使用者鍵入關鍵字並檢索之,欄位上方並提供檢索範圍的選擇。而其檢索結果則如圖10所示,輸出符合鍵入關鍵字的檢索結果,並依照先前語意網文件的排名給予排序。而其單筆資料則提供了文件中出現關鍵字的部份段落、檔案類型、檢索日期、檔案大小、Swoogle對於語意網文件所製作的後設資料以及快取檔案。
伍、結論
因為網路資源的爆炸性成長,大量的資訊造成取用上的障礙,雖然搜尋引擎如GOOGLE在目前滿足了大多數使用者的需求,可是就本質而言,全文檢索對於大量且無序的網路資源基本上是效率極低的,並且檢索結果也多是不相關的文件。
語意網的發想便是為了組織網路上的資源而生,同時也是為了利用僅被當作載體的電腦運算能力。其目標是將所有的網頁以有組織的方式連結起來,並且提供代理人自動驗證演算的能力,進而可以替人進行簡單的判斷。
目前對於語意網檢索的研究多是基於實驗室的小規模實驗集,仍然無法完全呈現真實世界的現實情況。此一問題仍待語意網文件大量產出過後,方能擁有一大規模的實驗測試集。
筆者在研究伊始本是想要就傳統搜尋引擎的檢索效能以及基於語意標註的語意檢索上兩者之間的差異性,但是在檢索既有的文獻之後,發現目前尚無對於此一議題的研究。雖然語意網的前提是經過組織後的網路資源,勢必會比目前傳統的無序的全文資料提供更好的檢索效率,但是仍有必要進一步驗證語意標註及關鍵字檢索彼此之間的優劣。但囿於當前相關的資訊過少,因此調整研究方向為提供語意網文件檢索的搜尋引擎。其與傳統搜尋引擎的不同點在於對於語意標註的檢索及索引,其目的在於提供研究人員檢索到適合的知識本體或RDF檔,避免重複製作相同領域的知識本體,但是對其功能並不包括以語意標記強化文字檢索。
因此未來研究的方向應該是以基於知識本體的自動化以及語意網文件的自動化的基礎,以龐大的測試資料集為前提下,驗證傳統的全文檢索搜尋引擎以及基於語意標記的搜尋引擎彼此之間的檢索效能及滿足使用者需求兩者程度上的差異。
陸、參考文獻
Berners-Lee, T., Hendler, J., & Lassila, O. (2001). The semantic Web. Scientific American, 284(5), 28-37.
Ding, L., Finin, T., Joshi, A., Pan, R., Cost, R. S., Peng, Y., et al. (2004). Swoogle: A Search and Metadata Engine for the Semantic Web. Proceedings of the Thirteenth ACM Conference on Information and Knowledge Management.
Ding, L., Finin, T., Joshi, A., Peng, Y., Pan, R., & Reddivari, P. (2005). Search on the Semantic Web. Computer, 38(10), 62-69.
Finin, T., Mayfield, J., Joshi, A., Cost, R. S., & Fink, C. (2005). Information Retrieval and the Semantic Web. System Sciences, 2005. HICSS'05. Proceedings of the 38th Annual Hawaii International Conference on, 113a-113a.
Grigoris Antoniou, F. v. H. (2006). 語意網技術導論 (初版 ed.). 臺北市: 碁峰資訊.
Köhler, J., Philippi, S., Specht, M., & Rüegg, A. (2006). Ontology based text indexing and querying for the semantic web. Knowledge-Based Systems, 19(8), 744-754.
Madalli, D. P. (2006). ONTOLOGIES AS KNOWLEDGE STRUCTURES FOR SEMANTIC RETRIEVAL. Information Studies, 12(4), 205-212.
Mayfield, J., & Finin, T. (2003). Information retrieval on the Semantic Web: Integrating inference and retrieval. SIGIR Workshop on the Semantic Web, Toronto, 1.
Shah, U., Finin, T., & Joshi, A. (2002). Information retrieval on the semantic web. Proceedings of the eleventh international conference on Information and knowledge management, 461-468.
Swoogle, http://swoogle.umbc.edu/.
Yufei, L., Yuan, W., & Xiaotao, H. (2007). A Relation-Based Search Engine in Semantic Web, IEEE Transactions on Knowledge & Data Engineering (Vol. 19, pp. 273-281).
石翌軼, 宋自林, & 尹康銀. (2006). 一種基於語義的Web資料搜索引擎方法研究. 山東大學學報(理學版)(03).
江克勤, 張玉州, & 王一賓. (2007). 基於語義的Web資訊檢索. 電腦技術與發展(01).
徐瑩, 徐福緣, & 李生琦. (2006). 基於語義的智慧檢索在供需網中的應用. 上海理工大學學報(03).
曹二堂, & 劉玉林. (2006). 一種基於語義理解的元搜索引擎的研究. 電腦工程(07).
虞為, 曹加恒, 曾承, 黃敏, & 陳俊鵬. (2007). 基於語義索引詞的語義網資訊檢索模型. 電腦工程(03).
竇玉萌, & 王孟龍. (2006). 面向語義Web的搜索引擎構想. 情報探索(07).
羅慶雲, & 趙巾幗. (2007). 語義化Web的理論基礎與技術基礎. 甘肅聯合大學學報(自然科學版)(05).
2008年1月14日 星期一
只要再五天
五天之後
不知道天空會是什麼顏色
走走停停的 這學期也要過了
人生地不熟的一個學期
可是我作業還是沒寫完
今天晚上 我又把語意網拿出來講了
感覺有比第一次講的好些
<註:第一次的時候根本就是在亂做 連自己在講什麼都不知道>
然後老師的評語是:"題目太簡單"
"建議你書面可以從本體自動化切入"
"老師在美國的時候就有做過semantic net了"
"題目是你自己挑的 你有責任把它做的有深度一點"
嗚呼
我也知道知識本體是整個語意網的核心啊 CORE C˙O˙R˙E
問題是本體論複雜到靠杯 所以才跳過嘛....
人生真是變化無常
我原本以為可以不用再看書了 沒想到還是要繼續
謝謝我的同學容忍我1份簡報報告兩次 應該聽的很ㄙㄟ吧 ㄎㄎ
不過我禮拜四即將邁向1份簡報PK9學分
希望不要有人爆我料....
-整理文獻請愛用ENDNOTE-
被當掉我就去當兵啦 不管了
不知道天空會是什麼顏色
走走停停的 這學期也要過了
人生地不熟的一個學期
可是我作業還是沒寫完
今天晚上 我又把語意網拿出來講了
感覺有比第一次講的好些
<註:第一次的時候根本就是在亂做 連自己在講什麼都不知道>
然後老師的評語是:"題目太簡單"
"建議你書面可以從本體自動化切入"
"老師在美國的時候就有做過semantic net了"
"題目是你自己挑的 你有責任把它做的有深度一點"
嗚呼
我也知道知識本體是整個語意網的核心啊 CORE C˙O˙R˙E
問題是本體論複雜到靠杯 所以才跳過嘛....
人生真是變化無常
我原本以為可以不用再看書了 沒想到還是要繼續
謝謝我的同學容忍我1份簡報報告兩次 應該聽的很ㄙㄟ吧 ㄎㄎ
不過我禮拜四即將邁向1份簡報PK9學分
希望不要有人爆我料....
-整理文獻請愛用ENDNOTE-
被當掉我就去當兵啦 不管了
2007年12月28日 星期五
期末作業海
雖然12月一開始就說作業很多
到現在我也才完成一個報告 惰性跟時間管理是學習的兩大敵人
管理心理學----已口頭 剩書面-01/23
資訊科學----什麼都沒有--01/21口頭 01/22書面
資訊組織----什麼都沒有---01/02口頭 01/18書面
自動分類與索引 ---什麼都沒有--01/17口頭 01/24書面
不過我後三科題目都一樣 ...可是我還是什麼都沒看
想來想去還是因為沒有修研究方法 根本不知道自己要做什麼
老師也沒說報告的深度跟廣度要如何
所以就很怕做出來的東西會被笑
我除了期末報告海以外 還要在01/10以前改完280份傳播學考卷....哪改得完啊 我要外包
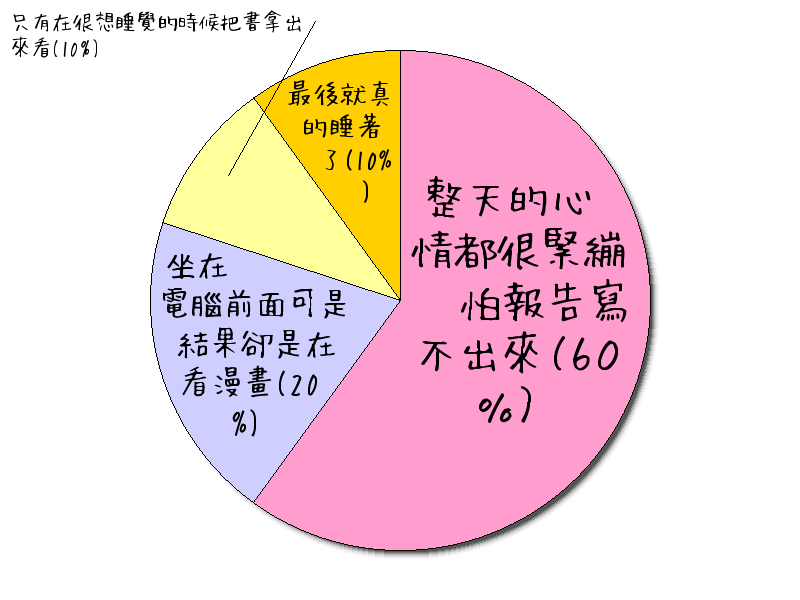
真煩 我還是去看少年快報好了 又是星期五了
到現在我也才完成一個報告 惰性跟時間管理是學習的兩大敵人
管理心理學----已口頭 剩書面-01/23
資訊科學----什麼都沒有--01/21口頭 01/22書面
資訊組織----什麼都沒有---01/02口頭 01/18書面
自動分類與索引 ---什麼都沒有--01/17口頭 01/24書面
不過我後三科題目都一樣 ...可是我還是什麼都沒看
想來想去還是因為沒有修研究方法 根本不知道自己要做什麼
老師也沒說報告的深度跟廣度要如何
所以就很怕做出來的東西會被笑
我除了期末報告海以外 還要在01/10以前改完280份傳播學考卷....哪改得完啊 我要外包
真煩 我還是去看少年快報好了 又是星期五了
訂閱:
文章 (Atom)